
Fundador & Coordenador do Núcleo de Tecnologia e Sistemas
·Categoria: Tecnologia e Sistemas·33 min de leitura
Quatro camadas, um handoff: o que o Gemini 4 e seus pares revelam sobre a nova arquitetura dos modelos
Análise documental das famílias Gemini 4, Claude 5.2/5.5 e GPT-6/6.1: como os laboratórios convergiram para quatro camadas de uso e por que o valor migrou do modelo único para o protocolo de handoff.
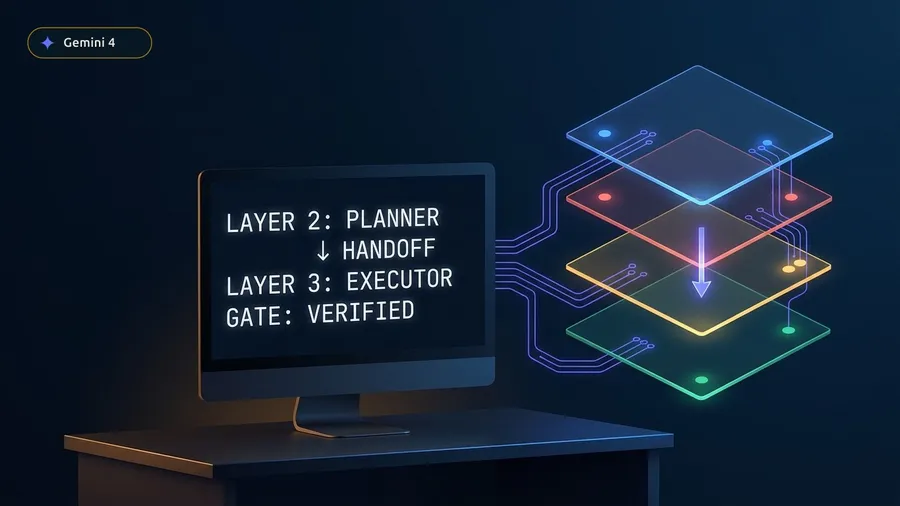
A corrida por um modelo único capaz de planejar sistemas inteiros, executar código em lote e triar milhões de requisições acabou; com o lançamento do Gemini 4 Hydrogen em 12 de novembro de 2026, Google DeepMind, Anthropic e OpenAI convergiram para uma arquitetura explícita em quatro camadas, deslocando a vantagem de engenharia do modelo isolado para o protocolo de handoff entre planejador caro e executor rápido.
Para quem desenha integrações empresariais e pipelines de desenvolvimento assistido por IA, essa mudança reordena decisões que antes pareciam triviais. Até recentemente, escolher um modelo era selecionar uma única linha de tabela por relação entre inteligência e preço por milhão de tokens. Os lançamentos de outubro e novembro de 2026 mostram que os três principais laboratórios reorganizaram seus catálogos em estratos funcionais quase espelhados, com diferenças profundas de preço, janela útil, latência, restrições de acesso e papel dentro de um harness agêntico.
Este texto é uma análise documental comparativa baseada nas documentações oficiais, model cards, tabelas de preço e notas de engenharia publicadas por Google DeepMind, Google AI Studio, Google Antigravity, Anthropic e OpenAI até 15 de novembro de 2026. Não apresenta benchmarks próprios nem medições empíricas de laboratório independente; quando há inferência arquitetural ou econômica sobre essas fontes, ela aparece explicitamente marcada como nossa leitura.
A escada das quatro camadas
A publicação do Introducing Gemini 4 Hydrogen em 12 de novembro de 2026 fechou o desenho que já vinha se formando nos outros dois laboratórios. Quando observados lado a lado, o catálogo do Google (com a família Gemini 4 somada ao Gemini 3.5 Flash-Lite), o da Anthropic (com as séries Claude 5.2 e 5.5 em Models Overview) e o da OpenAI (com as séries GPT-6 e 6.1) ocupam exatamente as mesmas quatro posições estruturais.
| Camada e papel | Google (Gemini 4 / 3.5) | Anthropic (Claude 5.2 / 5.5) | OpenAI (GPT-6 / 6.1) |
|---|---|---|---|
| 1. Acesso restrito e risco alto | Programas fechados (Fairwind) sobre variantes de fronteira | Claude Mythos 5.2 (Cyber e Life Sciences), $8 / $40 | GPT-6 Cyber (Daybreak Red, $20 / $100) e GPT-Rosalind |
| 2. Fronteira de planejamento e revisão | Gemini 4 Carbon ($2/$10 até 30/11; $4/$20 em 01/12) e Argon | Claude Fable 5.2 ($8 / $40) e Claude Opus 5.5 ($4 / $20) | GPT-6 Astra ($10 / $50 curto; $20 / $75 acima de 272K) |
| 3. Trabalho diário e execução agêntica | Gemini 4 Hydrogen ($1,50 / $7,50 plano em 1M; gratuito com limite) | Claude Sonnet 5.5 ($2 / $10) e Opus 5.5 em esforço médio | GPT-6.1 Sol ($2 / $10) e GPT-6.1 Terra ($1 / $5) |
| 4. Alto volume, triagem e baixo custo | Gemini 3.5 Flash-Lite ($0,30 / $2,50; esforço minimal a high) | Claude Haiku 5.5 ($0,10/$0,50 até 100K; $0,50/$2,50 acima) | GPT-6 Luna ($0,10 / $0,50 até 272K; $0,20 / $0,75 acima) |
Essa distribuição não surgiu por acaso. Em cada laboratório, o topo deixou de ser um produto de vitrine livre para todo desenvolvedor e passou a exigir credenciamento setorial ou justificativa explícita de custo. Abaixo dele, um estrato de fronteira sustenta planejamento complexo, depuração de causa raiz e revisão arquitetural. Logo abaixo, uma camada intermediária rápida concentra a execução contínua de ferramentas, edições em múltiplas etapas e laços de teste. Na base, modelos enxutos absorvem classificação, extração, roteamento e tarefas repetitivas onde latência e centavos por milhão de tokens determinam a viabilidade da operação.
flowchart TD
    C1["Camada 1: Acesso Restrito (Mythos 5.2 / GPT-6 Cyber / Fairwind)"] --> C2["Camada 2: Fronteira e Planejamento (Carbon / Fable 5.2 / Opus 5.5 / Astra)"]
    C2 -->|"Handoff de plano e gatilhos"| C3["Camada 3: Execução Agêntica Diária (Hydrogen / Sonnet 5.5 / 6.1 Sol)"]
    C3 -->|"Retorno por atrito ou escolha de desenho"| C2
    C3 -->|"Subtarefas simples e triagem"| C4["Camada 4: Alto Volume (3.5 Flash-Lite / Haiku 5.5 / Luna)"]
A consequência prática dessa escada aparece na própria documentação dos fornecedores. A Anthropic declara explicitamente em Claude Fable and Mythos 5.2 que o Claude Fable e o Claude Mythos são o mesmo modelo subjacente: o mesmo modelo de fronteira é separado em um produto geral caro (Fable 5.2, $8 / $40) e em uma variante restrita para programas de cibersegurança e ciências da vida (Mythos 5.2). Ainda nessa página, a fornecedora recomenda começar pelo Claude Opus 5.5 como seu modelo principal mais forte para uso diário, enquanto o guia Choosing a model orienta ajustar o parâmetro effort antes de trocar de modelo e iniciar o Opus 5.5 em seu esforço padrão (medium). Em Optimizing for cost and intelligence, a orientação para a maioria das cargas com agentes reforça o ponto: começar pelo Claude Opus 5.5 em esforço padrão (medium).
A OpenAI organiza seu catálogo na mesma direção em Models e Model selection: gpt-6-astra ($10 / $50 no contexto curto) ocupa o topo geral, gpt-6.1-sol ($2 / $10) é posicionado como entrega de desempenho próximo ao do Astra para trabalhos complexos a custo menor, enquanto gpt-6-cyber ($20 / $100) exige aprovação no programa Daybreak Red segundo a ficha de GPT-6 Cyber e gpt-rosalind-research (GPT-Rosalind) atende organizações aprovadas em ciências da vida.
Nossa leitura: a antiga divisão binária entre “modelo grande” e “modelo mini” não descreve mais a realidade de produção. Os laboratórios estabilizaram quatro papéis porque raciocínio prolongado, riscos de capacidade dual e velocidade em laços agênticos são forças incompatíveis em um único ponto de preço e latência.
Camada 1 — Acesso restrito
Project Fairwind (Carbon / Argon), Claude Mythos 5.2 ($8 / $40), GPT-6 Cyber ($20 / $100, Daybreak Red) e GPT-Rosalind.
Camada 2 — Planejamento e revisão
Carbon ($2 / $10 até 30/11; $4 / $20 em 01/12), Fable 5.2 ($8 / $40), Opus 5.5 e GPT-6 Astra ($10 / $50 curto).
Camada 3 — Execução diária agêntica
Hydrogen ($1,50 / $7,50 plano em 1M; gratuito com limite), Sonnet 5.5 ($2 / $10), GPT-6.1 Sol ($2 / $10) e Terra ($1 / $5).
Camada 4 — Alto volume e triagem
3.5 Flash-Lite ($0,30 / $2,50), Haiku 5.5 ($0,10 / $0,50 <=100K) e GPT-6 Luna ($0,10 / $0,50 <=272K).
A anatomia do Gemini 4 e o aperto sobre o Argon
Para entender por que o lançamento do Hydrogen reorganiza o portfólio do Google, é preciso ler em sequência os três model cards publicados pela DeepMind entre outubro e novembro de 2026.
O ponto de partida foi o Gemini 4 Argon Model Card (13 de outubro de 2026), que o descreve como um modelo transformer esparso de mistura de especialistas (MoE) em larga escala, com janela unificada de 1.048.576 tokens, saída síncrona padrão de 65.536 tokens (decodificação longa até 1M via streaming/SDK), níveis de pensamento low, medium (padrão) e high, e corte de conhecimento em março de 2026.
Em 28 de outubro de 2026 veio o anúncio do Carbon no programa Fairwind em Introducing Gemini 4 Carbon, seguido pelo Gemini 4 Carbon Model Card em 10 de novembro, que registra ser o Gemini 4 Carbon baseado no Gemini 4 Argon. Mantendo a mesma janela de 1M, níveis low/medium/high e corte de março de 2026, o Carbon registra na autoavaliação da DeepMind índice 59 no Artificial Analysis Index v5.0 (contra 50 do Argon), 61,2% no FrontierSWE 2, 65,2% no Terminal-Bench 4.0 (AA), 81,5% no OSWorld-2.1 Offline e 53,9% no AutomationBench (Zapier).
Em 12 de novembro de 2026, o Gemini 4 Hydrogen Model Card fecha a linhagem ao registrar que o Gemini 4 Hydrogen é adaptado do Gemini 4 Carbon. As notas em What’s new in Gemini 4 Hydrogen, What’s new in Gemini 4 Carbon e What’s new in Gemini 4 Argon detalham quatro diferenças operacionais:
- Pensamento padrão elevado: ao contrário de Argon e Carbon (
medium), o Hydrogen adotahighcomo padrão e adicionaxhigh(Extrano Antigravity). - Lote não-streaming dobrado: entrega até
65.536tokens por chamada não-streaming em REST e SDK, frente a32.768tokens por requisição não-streaming via REST em Carbon e Argon. - Somente cache implícito: não suporta cache explícito de contexto no lançamento, oferecendo cache implícito com
95%de desconto a partir de4.096tokens. - Faixa gratuita disponível: ausente em Carbon e Argon, existe no Hydrogen com limite de taxa e uso de dados para aprimoramento de produtos segundo a tabela de preços.
Quando cruzamos essa ficha técnica com Gemini API Pricing, surge a ruptura econômica da família. Até 30 de novembro de 2026, Carbon e Argon compartilham tarifa introdutória de $2,00 / $10,00 (entrada/saída, incluindo pensamento). Em 1º de dezembro de 2026, ambos dobram para $4,00 / $20,00 (cache implícito de $0,10 para $0,20). O Hydrogen não tem degrau promocional: custa $1,50 / $7,50 planos em toda a janela de 1M (cache implícito $0,075), acima do Gemini 3.5 Flash-Lite ($0,30 / $2,50).
≤100K no Haiku 5.5 e ≤272K na família GPT-6 / 6.1).Nossa leitura: quando a tabela de dezembro entrar em vigor, o Gemini 4 Argon ficará comprimido em um espaço estreito. Pelo mesmo preço de $4,00 / $20,00 do Carbon na API paga, o desenvolvedor tem pouco incentivo financeiro para escolher o Argon em vez do Carbon; e, olhando para baixo, o Hydrogen custa menos da metade do valor de dezembro ($1,50 / $7,50), pontuando 51 no Artificial Analysis Index no padrão high e 54 em xhigh segundo o blog oficial, contra 50 do Argon. Na API paga, o Argon tende a perder razão de existir fora do papel residual de fallback nos planos de assinatura do Antigravity onde o Carbon não está liberado.
Topo: Carbon absorve o planejamento
Com pontuação 59 no Artificial Analysis Index e a mesma tarifa de dezembro do Argon ($4 / $20), concentra decisões arquiteturais e revisões críticas.
Aperto: Argon sem espaço na API paga
Empata em preço com o Carbon ($4 / $20 em 01/12) entregando 50 pontos no índice; na prática, resta como fallback no Antigravity onde o Carbon não está liberado.
Base: Hydrogen vence na execução
Custa menos da metade da tabela de dezembro ($1,50 / $7,50), pontua 51 no padrão high (54 em xhigh) e entrega janela plana até 1M.
A comparação de preços da tabela de dezembro considera a faixa padrão curta de cada provedor (
<=100KnoClaude Haiku 5.5e<=272Kna família GPT-6/6.1). Ultrapassar esses limiares multiplica a conta por fatores de 1,5x a 5x sem aviso automático no código.
O que muda na interface: orquestrador, executor e o custo do roteamento
Se os catálogos convergirem para quatro camadas e ninguém usar o modelo mais caro para tudo, o problema técnico central deixa de ser “qual modelo é mais inteligente” e passa a ser como dividir uma tarefa entre camadas sem gastar mais em coordenação do que se economiza na execução.
A resposta mais explícita do Google até aqui veio no mesmo dia 12 de novembro, com a introdução do modo Orchestrator descrito no blog Gemini 4 Hydrogen in Google Antigravity e detalhado na documentação de Antigravity Models. Em vez de manter o usuário preso a um único modelo por conversa, o Orchestrator realiza um handoff bidirecional dentro de uma mesma resposta entre um planejador de fronteira (Orchestrator (Carbon) ou Orchestrator (Argon)) e o executor rápido (Gemini 4 Hydrogen).
Na API programática do Google AI Studio, o mesmo padrão arquitetural aparece suportado pelo parâmetro previous_interaction_id na Interactions API, conforme documentado em What’s new in Gemini 4 Hydrogen. Esse encadeamento stateful permite alternar turnos de planejamento no gemini-4-carbon com turnos de execução no gemini-4-hydrogen dentro da mesma sessão sem reenviar todo o histórico manualmente:
# Padrão de alternância documentado na Interactions API (AI Studio)
plan_turn = client.interactions.create(
    model="gemini-4-carbon",
    input="Analise os módulos afetados e defina os critérios de parada."
)
exec_turn = client.interactions.create(
    model="gemini-4-hydrogen",
    previous_interaction_id=plan_turn.id,
    input="Execute o plano no repositório e rode a suíte de testes."
)
Fonte conceitual: fluxo com previous_interaction_id descrito em What’s new in Gemini 4 Hydrogen (chamada ilustrativa).
Dentro do Antigravity, o comportamento do Orchestrator obedece a um contrato estrito de papéis e limites. O planejador inicia em modo somente leitura, inspeciona o código e redige um plano concreto acompanhado de gatilhos explícitos de re-planejamento. Em seguida, passa o controle ao Hydrogen para editar arquivos, rodar builds e executar testes. Se o Hydrogen encontrar atrito — por exemplo, quando a verificação falha duas vezes consecutivas — ou esbarrar em uma decisão de arquitetura não resolvida no plano inicial, o controle volta ao planejador dentro do mesmo fluxo. A configuração dos subagentes do Orchestrator vem travada pelo harness: --effort, /effort e seleção manual de nível de pensamento ficam desabilitados nesse modo.
sequenceDiagram
    participant Dev as Desenvolvedor
    participant Orch as Orchestrator Carbon/Argon
    participant Hyd as Executor Hydrogen
    participant Tests as Build e Testes

    Dev->>Orch: Tarefa e restrições de contexto
    Note over Orch: Inspeção somente leitura do código
    Orch->>Hyd: Plano concreto + gatilhos de re-planejamento
    Hyd->>Tests: Edita código e executa suíte
    Tests-->>Hyd: Falha na verificação (1ª tentativa)
    Hyd->>Tests: Ajusta implementação e re-executa
    Tests-->>Hyd: Falha na verificação (2ª tentativa)
    Hyd-->>Orch: Devolve controle (gatilho de atrito)
    Orch-->>Dev: Re-planeja ou solicita decisão arquitetural
Essa mecânica exige atenção cuidadosa às discrepâncias entre fontes primárias e às restrições comerciais. Nos dois anúncios do dia 12 de novembro, o Google reportou exatamente os mesmos ganhos relativos para o Orchestrator (Carbon) combinado ao Hydrogen frente ao Carbon sozinho: 24% menos consumo de cota e 19% mais velocidade com desempenho equivalente em tarefas difíceis. Contudo, o blog principal do Google atribui essa medição ao benchmark Terminal-Bench 4.0, enquanto o blog do Antigravity atribui os mesmos 24% e 19% ao Terminal-Bench 4.1. Além disso, a disponibilidade do Orchestrator (Carbon) é restrita a assinantes do plano Google AI Ultra (indisponível nos planos Pro e Enterprise em 15 de novembro de 2026), deixando o Orchestrator (Argon) como única opção em Pro e em avaliação (trial) com dispositivos elegíveis, e nenhum dos dois modos disponível no plano Enterprise segundo a tabela de Antigravity Models.
Mais importante do que o marketing de um único fluxo bem-sucedido é verificar quando o roteamento entre modelos realmente compensa. Aqui, a documentação de engenharia publicada pela Anthropic em Optimizing for cost and intelligence e no guia Advisor tool funciona como um freio empírico indispensável contra o entusiasmo acrítico por arquiteturas multi-modelo.
Nas medições internas da Anthropic com agentes gerenciados (Managed Agents), delegar sub-tarefas de um orquestrador para modelos menores não superou o ajuste de esforço em um único modelo dentro de uma mesma janela de contexto. Quando a tarefa cabia em uma única janela, simplesmente reduzir o parâmetro effort do Opus 5.5 entregou melhor equilíbrio entre pontuação e custo do que dividir o trabalho entre orquestrador e subagentes. A delegação só trouxe ganho mensurável em dois cenários específicos: (1) trabalho rotineiro com uma cauda longa de chamadas repetitivas de baixo valor unitário, ou (2) tarefas que excediam a capacidade de uma única janela de contexto — caso ilustrado por um benchmark interno de busca de defeitos em que Opus 5.5 coordenando subagentes Sonnet 5.5 custou cerca de um terço a menos por peça analisada mantendo pontuação semelhante à do Opus 5.5 sozinho.
O experimento da própria Anthropic com a ferramenta advisor_20260301 confirma o risco de coordenação excessiva. Quando o executor Opus 5.5 em esforço high foi pareado com um consultor Fable 5.1 sob demanda, o conjunto alcançou 90,1% no benchmark agêntico interno de código — um ganho de apenas 1,7 ponto percentual sobre o executor sozinho (na borda do ruído estatístico entre execuções), ao custo de $2,92 por tentativa, cerca de 2,1 vezes mais caro do que rodar o executor isolado (com média de ~1,4 consulta por tentativa). O próprio guia da Anthropic reconhece que o resultado acabou pousando próximo da curva de custo-desempenho que o Opus 5.5 já atingia ajustando seu esforço interno.
Os números internos da Anthropic no subconjunto de 463 problemas sem dependência de rede do SWE-bench Pro ilustram a mesma lógica: Opus 5.5 em esforço medium marcou 93,1% a $0,22 por problema contra 92,4% do Fable 5.1 a $1,17; em esforço xhigh, o Opus 5.5 chegou a 96,5% a $0,75 contra 96,3% do Fable 5.2 (em esforço padrão high) a $1,39 — com a ressalva registrada na nota 3 da tabela da Anthropic de que o Fable 5.2 executou sem acesso à rede nos containers de avaliação, enquanto Fable 5.1 e Opus 5.5 contaram com acesso à rede; na tabela completa de 478 problemas, Opus 5.5 medium marcou 92,8% a $0,22 contra 92,3% do Fable 5.1 a $1,19.
A OpenAI segue lógica paralela na página Codex Models: seu modo Ultra é descrito explicitamente como uma execução que vai além de um único agente e aciona subagentes para acelerar trabalhos complexos, reservando subagentes coordenados para problemas maiores enquanto presets de esforço individual (que na interface ainda exibem nomes literais como Luna High, GPT-6 Sol Light, GPT-6 Sol Medium, Astra Light, Astra Medium e Astra Extra High, apesar de a API já listar gpt-6.1-sol) tratam do trabalho contínuo.
Nossa leitura: multi-modelo não é sinônimo automático de economia. Dividir uma sessão curta que caberia na janela de um único modelo de camada 3 (como Opus 5.5 medium, Hydrogen high ou gpt-6.1-sol) entre um planejador caro e um executor separado frequentemente adiciona latência de inicialização, reenvio de contexto e custo de supervisão sem retorno proporcional. O handoff se paga quando há assimetria real: planejamento profundo que evita dez ciclos errados de edição, isolamento de janelas de contexto que evita poluição de histórico, ou grande volume de operações mecânicas fora do caminho crítico de decisão.
Os degraus invisíveis da fatura e da cota
Quem olha apenas o preço-base por milhão de tokens na primeira coluna das tabelas de marketing comete o erro clássico de orçar pelo piso e faturar pelo teto. Em novembro de 2026, os três laboratórios mantêm multiplicadores não lineares embutidos no tamanho do contexto, na densidade de tokenização, nas classes de velocidade e na disciplina do cache.
Na Anthropic, o degrau mais abrupto está escondido justamente no modelo de entrada: conforme Claude Pricing, o claude-haiku-5-5 custa $0,10 de entrada e $0,50 de saída apenas até 100.000 tokens de prompt. No token 100.001, a tarifa salta 5 vezes, passando para $0,50 de entrada e $2,50 de saída — exatamente o preço cheio de modelos maiores na faixa inferior, tornando um Haiku com contexto inflado mais caro por requisição do que se esperava de um modelo de Camada 4. Além disso, a documentação de preços da Anthropic registra que o tokenizador introduzido a partir do Claude 4.7 gera aproximadamente 30% mais tokens para o mesmo texto em relação a gerações anteriores, um multiplicador silencioso sobre cada cálculo baseado em palavras ou caracteres. Em sentido inverso, o cache hit do Fable 5.2 e do Mythos 5.2 custa $0,20 (um quadragésimo da entrada cheia de $8,00), premiando agressivamente prefixos estáveis.
Na OpenAI, a armadilha equivalente é o degrau de 272K tokens documentado em OpenAI Pricing e nas fichas de GPT-6 Astra e GPT-6.1 Sol, que separa contexto curto (<=272K tokens de entrada) de contexto longo (>272K tokens de entrada). Ao cruzar 272.000 tokens de entrada em uma chamada de API, toda a requisição sofre multiplicador de 2x na entrada e no cache e 1,5x na saída. Um gpt-6.1-sol salta de $2 / $10 para $4 / $15; um gpt-6-astra sobe de $10 / $50 para $20 / $75. (Como exceção específica de produto, o gpt-6.1-sol dentro do Codex e do ChatGPT Work oferece janela padrão de 500K sem essa sobretaxa de contexto longo nas assinaturas.)
A OpenAI também introduziu um eixo vertical agressivo de velocidade sobre preço: usar Batch ou Flex reduz a conta à metade (0,5x), usar o modo Fast dobra o preço (2x) e ativar o modo Ultrafast aplica multiplicador de 6x sobre a tarifa padrão. Nessa escala, um gpt-6-astra rodando em Ultrafast atinge $60 de entrada e $300 de saída no contexto curto, chegando a $120 de entrada e $450 de saída se cruzar os 272K tokens; até o intermediário gpt-6.1-sol em Ultrafast custa $12 / $60 no contexto curto — mais caro do que o Fable 5.2 em velocidade padrão.
O Google optou por eliminar o degrau de contexto longo no Gemini 4 ($1,50 / $7,50 plano em toda a janela de 1M no Hydrogen; $2 / $10 até 30/11 e $4 / $20 a partir de 01/12 em Carbon e Argon), mas compensa com uma política de cache e cota que pune chamadas sem disciplina de prefixo. Como o Hydrogen não oferece explicit caching na estreia, economizar 95% na entrada depende de o harness preservar o prefixo imutável acima de 4.096 tokens a cada turno para acionar o cache implícito. Se um agente injeta timestamps dinâmicos, logs voláteis ou reordena arquivos no topo do prompt a cada rodada do laço de execução, cada passo paga integralmente por toda a janela acumulada.
Anthropic: corte de 100K no Haiku 5.5
Passar de 100K tokens multiplica a entrada e a saída por 5x ($0,10 / $0,50 para $0,50 / $2,50), somado ao tokenizador pós-4.7 com ~30% mais tokens por texto.
OpenAI: 272K × prioridade de latência
Acima de 272K, a conta dobra na entrada e sobe 1,5x na saída; combinada com modos Fast (2x) ou Ultrafast (6x), a fatura multiplica em duas dimensões.
Google: prefixo imutável no harness
Não há degrau de volume até 1M, mas o Hydrogen estreia apenas com cache implícito: inserir timestamps ou logs no topo do prompt anula os 95% de desconto.
O custo em esforço humano não desaparece com a velocidade: executar código
2,5xmais rápido comHydrogenou delegar para enxames de subagentes transfere o gargalo para a revisão humana. Sem contratos de verificação e critérios de aceite definidos antes da geração, a equipe economiza minutos de espera do terminal e passa horas revisando diffs longos, rastreando suposições silenciosas do planejador ou recuperando sessões em que o executor insistiu em caminhos errados.
Esse ponto raramente entra nas calculadoras de API, mas decide o saldo real de engenharia. Um executor de Camada 3 barato e rápido multiplica o volume de linhas produzidas por hora. Se o planejador de Camada 2 não escrever um plano verificável com critérios determinísticos de parada, ou se o time humano aceitar código gerado apenas porque os testes gerados pelo próprio agente passaram sem inspeção de contrato, o custo simplesmente muda da fatura do provedor para o passivo de manutenção e incidência em produção.
Limites, contra-evidências e riscos de segurança
Uma análise equilibrada das quatro camadas precisa começar por uma regra de higiene documental: todo número de benchmark publicado em anúncio ou model card é uma autoavaliação do próprio fabricante, executada sob configurações de harness, orçamento de pensamento e ambiente de container escolhidos pelo laboratório. Eles servem para mapear o posicionamento pretendido pelo fornecedor, não como verdade universal fora daquele harness.
Olhando de perto os próprios dados divulgados pelo Google em novembro de 2026, o Gemini 4 Hydrogen mostra avanços expressivos onde foi otimizado — como 57,0% no Terminal-Bench 4.1 (Cheating-adjusted), salto frente aos 18,2% do 3.8 Flash citados no blog com redução superior a 5x em afirmações fabricadas, além de 13,5% no SWE-sweep (contra 3,1% do Sonnet 5.5 e 5,8% do GPT-6.1 Terra), 76,1% no AutomationBench-AA (contra 71,8% do Sonnet 5.5 e 60,2% do Terra) e 58,8% no HLE-Diamond (contra 53,3% do Sonnet 5.5 e 47,3% do Terra).
Por outro lado, a mesma tabela do Gemini 4 Hydrogen Model Card deixa claro que o Hydrogen não é líder absoluto em todas as tarefas da Camada 3:
- No
Terminal-Bench 4.1 (Cheating-adjusted), oClaude Sonnet 5.5marca63,9%contra57,0%do Hydrogen. - No
OSWorld-2.1 Offline(uso de interface gráfica), oClaude Sonnet 5.5marca83,9%contra77,6%do Hydrogen (e74,2%do GPT-6.1 Terra). - No
Terminal-Bench-Science 0.1, oClaude Sonnet 5.5atinge59,9%e oGPT-6.1 Terrachega a58,3%, ambos acima dos51,4%do Hydrogen.
As ressalvas metodológicas e de segurança nas fontes primárias reforçam a necessidade de cautela na leitura desses números:
- Avaliações de cibersegurança sem salvaguardas padrão: enquanto o blog do Carbon de 28 de outubro de 2026 descreve os resultados de segurança cibernética (
88,2%no SEC-bench Pro,54,8%no ExploitGym e71,0%no CWE-bench) com a ressalva de avaliação sem salvaguardas (guardrails), o model card oficial publicado em 10 de novembro registra que os resultados desses benchmarks refletem o desempenho do modelo acessado pelo Programa Fairwind. Os índices do topo de cibersegurança refletem versões ou modos sob programa fechado, não o comportamento aberto da API padrão com filtros ativos. - Proximidade de limiares de segurança no próprio Hydrogen: o Gemini 4 Hydrogen Model Card registra que tanto para CBRN Biological Uplift quanto para Cybersecurity Uplift, o limiar crítico de capacidade (CCL) não foi atingido após testes direcionados adicionais, mas o patamar de alerta do CCL foi alcançado. Na avaliação de Stealth & Situational Awareness, mesmo sem atingir formalmente o limiar técnico (TCL), a DeepMind adotou postura preventiva explícita: informa aplicar mitigações de controle, monitoramento e segurança de modelo como se o TCL tivesse sido atingido, por precaução conservadora. Mesmo o modelo de trabalho diário dessa geração opera próximo a fronteiras que exigem monitoramento contínuo e controles de contaminação e exfiltração.
- Limitações operacionais em enxames agênticos: na documentação de Antigravity Swarm, embora múltiplos agentes possam trabalhar em paralelo em um quadro compartilhado, os trabalhadores compartilham o mesmo workspace por padrão (exigindo configuração explícita de
shareoubranchpelo coordenador para editar código simultaneamente sem colisão), um@verifiercostuma ser adicionado apenas a cada 2 a 4 trabalhadores utilizando o mesmo modelo padrão se não houver instrução contrária, e trabalhadores que esgotam cota pausam sem retomada automática quando a cota renova. Orquestrar paralelismo continua exigindo supervisão de estado e verificação humana ou determinística. - Assimetrias de container em benchmarks concorrentes: como já observado na nota 3 da tabela comparativa da Anthropic, até os resultados internos mais favoráveis a um modelo específico carregam diferenças de ambiente (como bloqueio de rede durante a avaliação do
Fable 5.2frente a execuções com rede em versões comparadas), reforçando que tabelas entre fornecedores ou mesmo entre revisões internas devem ser tratadas como referência direcional, nunca como garantia portátil para o seu repositório.
Critérios práticos para desenhar sua matriz de modelos hoje
Se os três laboratórios convergiram para quatro camadas, traduzir essa estrutura para projetos reais exige ancoragem em quatro decisões de engenharia:
- Separe papéis antes de fixar nomes de modelo (Arquitetura & Modelagem Formal): divida o fluxo em decisão/especificação, execução em laço, triagem/extração e revisão independente por trás de contratos explícitos de entrada e aborto. Com critérios de retorno claros (como devolver ao planejador após duas falhas seguidas de verificação), trocar
CarbonporOpus 5.5ouHydrogenporSonnet 5.5ou6.1 Solvira troca de configuração. - Preserve prefixos estáveis e vigie os degraus da tabela (Engenharia de Contexto): isole prompts de sistema e schemas de timestamps voláteis para sustentar cache implícito no
Hydrogen(>=4.096tokens) e acertos de cache (cache hits) baratos emClaude 5eGPT-6. Monitore os dois precipícios de preço —100Knoclaude-haiku-5-5(5x) e272Kna API OpenAI (2x entrada, 1,5x saída) — e restrinjaFast (2x)ouUltrafast (6x)a interações síncronas com humano na tela, deixando cargas em lote para Batch ou Flex (0,5x). - Exija especificação acionável antes de liberar o executor rápido (Condução de Agentes): nunca acione um modelo de Camada 3 sem arquivos-alvo, invariantes e gatilhos de re-planejamento definidos, pois gerar código veloz sobre requisito ambíguo transfere o custo para descarte e retrabalho. Quando a tarefa cabe em uma janela limpa, inicie em modelo único de trabalho diário (
Opus 5.5 medium,Hydrogen highou6.1 Sol) antes de pagar sobrecarga de múltiplos agentes. - Ancore o aceite e o handoff em portões determinísticos (Verificação & Qualidade): o sinal que devolve uma tarefa ao planejador ou aprova um merge não deve depender apenas da avaliação de outro modelo. Compilação, análise estática, validação de schema e suítes automatizadas precisam rodar a cada ciclo para impedir que velocidade de geração vire passivo de revisão.
A conclusão desta safra de lançamentos é direta: não existe mais um modelo único que faça sentido comprar para todas as linhas de um sistema. O Gemini 4 Hydrogen fecha a mesma arquitetura em quatro estratos montada por Anthropic e OpenAI — topo restrito, planejador sob demanda, executor diário veloz e base de alto volume. A economia real não vem da escolha isolada no catálogo, mas da clareza do contrato de handoff e da rigidez dos portões de verificação.
Notas de método
Apuração documental realizada em 15 de novembro de 2026, utilizando exclusivamente documentação oficial, model cards, guias de seleção e tabelas de preço publicadas pelos fabricantes (sem execução de benchmarks próprios).
Referências
- Google & DeepMind: Introducing Gemini 4 Hydrogen (11/2026); Introducing Gemini 4 Carbon (10/2026); model cards Argon, Carbon e Hydrogen (10–11/2026); Gemini API Pricing e notas de lançamento (Argon, Carbon, Hydrogen)
- Google Antigravity: Gemini 4 Hydrogen in Google Antigravity (11/2026); Models e Swarm (11/2026)
- Anthropic: Claude Fable and Mythos 5.2 (11/2026); Models Overview, Pricing, Choosing a model, Optimizing for cost and intelligence e Advisor tool
- OpenAI: Models, Pricing, Model selection, GPT-6 Astra, GPT-6.1 Sol, GPT-6 Cyber e Codex Models
Notas
- Os benchmarks citados são autoavaliações dos fabricantes em seus próprios harnesses; nenhuma métrica foi reproduzida por nós. Divergências entre fontes primárias (
Terminal-Bench 4.0vs.4.1para os mesmos24%e19%doOrchestrator; avaliação sem salvaguardas vs. Fairwind noCarbon; ausência de rede no container doFable 5.2nos 463 problemas do SWE-bench Pro) foram mantidas como publicadas. - A convergência em quatro camadas, a análise de compressão econômica do
Argon, os critérios de alocação de handoff e os riscos de transferência de custo para revisão humana são nossa leitura (Instituto People-T). - A imagem de abertura foi gerada por IA a partir do tema do artigo e não retrata tela de produto comercial. O símbolo do Google Gemini entra como ativo oficial sobreposto na composição, em uso nominativo e sem sugerir endosso (decisão de 11/11/2026).
Engenheiro de software com mais de 12 anos de experiência na sustentação de sistemas educacionais, arquitetura de dados e integrações críticas entre ERPs e ambientes de aprendizagem.